
Почему выбор функций?
Выбор функций - это процесс поиска и выбора наиболее полезных функций в наборе данных. Это важный этап в конвейере машинного обучения. Причина, по которой мы должны заботиться о методе выбора функций, связана с плохими последствиями наличия ненужных функций в нашей модели:
- переоснащение, снижение производительности обобщения на тестовой выборке.
- снизить скорость тренировки
- уменьшить объяснимость модели
Основные типы инструментов выбора функций
В общем, существует три типа инструментов выбора функций (хотя я не знаю, кто это определил):
- На основе фильтра. В подходах к фильтрации используется алгоритм ранжирования или сортировки, чтобы отфильтровать менее полезные функции.
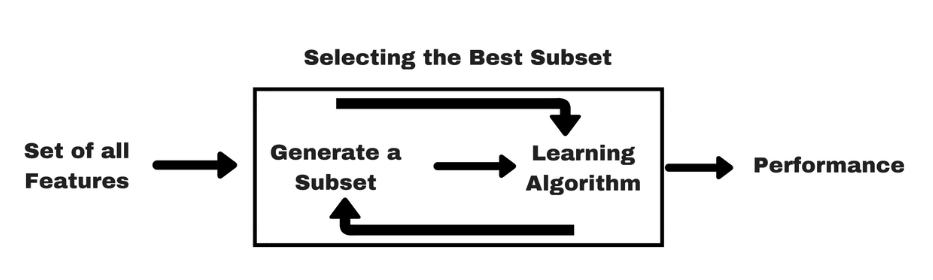
- На основе оболочки. Методы оболочки рассматривают выбор набора функций как проблему поиска. Подходы с оболочкой обычно выбирают функции путем непосредственного тестирования их влияния на производительность модели.
- Встроенные. Встроенные методы используют алгоритмы со встроенными методами выбора функций. Например, Лассо.
Теперь давайте рассмотрим каждый метод более подробно.
1 - Метод на основе фильтра
Методы фильтрации обычно применяются на этапе предварительной обработки.

1.1 - Порог отклонения
Пороговые значения дисперсии удаляют объекты, значения которых не сильно меняются от наблюдения к наблюдению (т. Е. Их дисперсия падает ниже порогового значения). Эти функции не представляют особой ценности. Мы можем легко применить этот метод, используя инструменты выбора функций sklearn.
from sklearn.feature_selection import VarianceThreshold1.2 - Порог корреляции
Пороги корреляции удаляют признаки, которые сильно коррелированы с другими (т. Е. Их значения меняются очень аналогично другим). Эти функции предоставляют избыточную информацию.
Сначала рассчитываем все попарные корреляции. Затем, если корреляция между парой функций выше заданного порогового значения, мы удалим ту, которая имеет большую среднюю абсолютную корреляцию с другими функциями.
1.3 - Выбор одномерного признака
При одномерном выборе признаков каждая особенность исследуется индивидуально, чтобы определить силу связи признака с переменной отклика. Существует множество различных вариантов одномерного выбора.
- Корреляция Пирсона
Один из простейших методов понимания связи функции с переменной отклика - это коэффициент корреляции Пирсона, который измеряет линейную корреляцию между двумя переменными.
- Хи-квадрат

В этом методе мы вычисляем метрику хи-квадрат между целевой и числовой переменной и выбираем только желаемое количество переменных с лучшими значениями хи-квадрат.
from sklearn.feature_selection import SelectKBest
from sklearn.feature_selection import chi2
chi2_selector = SelectKBest(chi2, k=2)
X_kbest = chi2_selector.fit_transform(X, y)- F-значение ANOVA
Если объекты категориальные, вычислите статистику хи-квадрат (χ2) между каждой функцией и целевым вектором. Однако, если признаки являются количественными, вычислите F-значение ANOVA между каждым признаком и целевым вектором.
Оценки F-значения проверяют, значительно ли различаются ли, когда мы группируем числовой признак по целевому вектору, средние значения для каждой группы.
from sklearn.feature_selection import SelectKBest
from sklearn.feature_selection import f_classif
fvalue_selector = SelectKBest(f_classif, k=2)
X_kbest = fvalue_selector.fit_transform(X, y)- Взаимная информация и коэффициент максимальной информации (MIC)
Более надежным вариантом оценки корреляции является взаимная информация, которая измеряет взаимную зависимость между переменными.
Однако использовать его напрямую для ранжирования функций может быть неудобно по двум причинам. Во-первых, это не показатель и не нормализованный (т.е.не находится в фиксированном диапазоне), поэтому значения MI могут быть несопоставимыми между двумя наборами данных. Во-вторых, может быть неудобно выполнять вычисления для непрерывных переменных: в общем, переменные необходимо дискретизировать путем объединения в интервалы, но оценка взаимной информации может быть весьма чувствительной к выбору интервалов.
Максимальный информационный коэффициент - методика, разработанная для устранения этих недостатков. Он ищет оптимальное объединение и превращает оценку взаимной информации в показатель, который находится в диапазоне [0; 1]. В python MIC доступен в библиотеке minepy.
2 - Метод на основе оболочки
Методы оболочки основаны на алгоритмах жадного поиска, поскольку они оценивают все возможные комбинации функций и выбирают комбинацию, которая дает наилучший результат для конкретного алгоритма машинного обучения. Обратной стороной этого подхода является то, что тестирование всех возможных комбинаций функций может быть очень затратным в вычислительном отношении, особенно если набор функций очень велик.
Очевидно, что это дорогостоящий в вычислительном отношении подход для поиска наиболее эффективного подмножества функций, поскольку они должны сделать несколько вызовов алгоритма обучения.
2.1 - Поиск в прямом направлении
На первом этапе поэтапного выбора признаков эффективность классификатора оценивается по каждому признаку. Из всех функций выбирается наиболее эффективная функция.
На втором этапе первая функция проверяется в сочетании со всеми другими функциями. Выбирается комбинация двух функций, обеспечивающая наилучшую производительность алгоритма. Процесс продолжается до тех пор, пока не будет выбрано указанное количество функций.
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.metrics import roc_auc_score
from mlxtend.feature_selection import SequentialFeatureSelector feature_selector = SequentialFeatureSelector(RandomForestClassifier(n_jobs=-1),
                          k_features=15, forward=True,
                          verbose=2, scoring=’roc_auc’, cv=4)
2.2 - Обратный поиск
Как следует из названия, шаг назад выбор функции - полная противоположность шагу выбора функции вперед, который мы изучали в предыдущем разделе. На первом этапе шага назад выбора функции одна функция удаляется циклическим способом из набора функций и оценивается производительность классификатора.
Набор функций, обеспечивающий наилучшую производительность, сохраняется. На втором этапе снова удаляется одна функция в циклическом режиме и оценивается производительность всей комбинации функций, кроме двух. Этот процесс продолжается до тех пор, пока указанное количество объектов не останется в наборе данных.
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.metrics import roc_auc_score
from mlxtend.feature_selection import SequentialFeatureSelectorfeature_selector = SequentialFeatureSelector(RandomForestClassifier(n_jobs=-1),
                          k_features=15, forward=False,
                          verbose=2, scoring=’roc_auc’, cv=4)
2.3 - Рекурсивное исключение функции
Это жадный алгоритм оптимизации, который направлен на поиск наиболее эффективного подмножества функций. Он неоднократно создает модели и оставляет в стороне лучшие или худшие функции на каждой итерации. Он строит следующую модель с левыми элементами, пока не будут исчерпаны все функции. Затем он ранжирует функции в порядке их исключения.
>>> from sklearn.datasets import make_friedman1
>>> from sklearn.feature_selection import RFE
>>> from sklearn.svm import SVR
>>> X, y = make_friedman1(n_samples=50, n_features=10, random_state=0)
>>> estimator = SVR(kernel="linear")
>>> selector = RFE(estimator, 5, step=1)
>>> selector = selector.fit(X, y)
3 - Встроенный метод

Встроенные методы используют алгоритмы, которые имеют встроенные методы выбора функций. Например, у Lasso и RF есть свои собственные методы выбора признаков. Регуляризатор лассо заставляет многие веса объектов равняться нулю.
Мы также можем использовать RandomForest для выбора функций в зависимости от их важности. Мы также могли использовать LightGBM. Или объект XGBoost, если у него есть атрибут feature_importances_.
использованная литература
机器 学习 中 的 特征 选择 方法 概述
Feature Selection 是 在 模型 构建 过程 中 选择 、 利于 提高 预测 效果 的 特征 子 的 过程 机器 学习 中 的 特征 选择 (Выбор функции) 也 被 称为 Выбор переменной 或 Атрибут... jasonlian.github.io