
Шаблон проектирования Python для написания масштабируемых конвейеров обработки данных
Некоторые из достоинств Python - его гибкость и простота. Однако эти способности - палка о двух концах. Если вы не приступите к разработке повторно используемого, управляемого и тестируемого кода на раннем этапе, вы столкнетесь с проблемами прогресса по мере масштабирования вашей кодовой базы.
При использовании модуля Python Pandas легко отказаться от объектно-ориентированного стиля кодирования. Распространенной ошибкой является написание быстрого кода, который сложно тестировать и масштабировать.
В этом посте показан шаблон проектирования для повторно используемого и не требующего обслуживания кода при обработке данных с помощью Pandas.
🪖 Цели поста
- Создайте конвейер метрик с Pandas
2. Конвейер рефакторинга, чтобы его можно было легко расширять и тестировать.
🐍 Кодовая база найдена здесь.
🦄 Набор данных
Мы будем использовать бесплатный набор данных от Kaggle, содержащий: "Полный список компаний-единорогов в мире".

Контекст
"Компания-единорог или стартап-единорог - это частная компания с оценкой более 1 миллиарда долларов. По состоянию на март 2022 года в мире насчитывается 1000 единорогов. Популярные бывшие единороги включают Airbnb, Facebook и Google. Варианты включают декакорн стоимостью более 10 миллиардов долларов и гектокорн стоимостью более 100 миллиардов долларов".
📊 Набор данных Kaggle Unicorn Companies найден здесь.
🧱 Построить конвейер метрик
Мы построим 3 таблицы статистики Unicorn, используя Pandas.
- Показатели на уровне страны
- Показатели временных рядов на уровне страны
- Метрики инвестора
🏆 Выигрышная комбинация методов панд
Мы будем использовать комбинацию методов Pandas, которые упростят манипулирование данными и сохранят наш пайплайн в чистоте.
pandas.DataFrame.explodeorpandas.DataFrame.meltpandas.DataFrame.groupbypandas.DataFrame.reset_indexpandas.merge
🌍 Статистика на уровне страны
Во-первых, мы рассчитаем количество единорогов в каждой стране и среднюю оценку единорогов (в миллиардах) в каждой стране.

📈 Пример графика с использованием выходной таблицы country_stats
График ниже является одним из примеров графика, созданного с помощью нашей таблицы country_stats. Мы можем быстро увидеть, что США лидируют в мире по общему количеству компаний-единорогов.

⏳ Временные ряды на уровне страны
Для этих показателей мы группируем по столбцам country и date_joined, чтобы подсчитать количество единорогов с течением времени и суммировать оценки.
💡 Обратите внимание, что ранее я отсортировал фрейм данных по date_joined.

➕ Совокупный временной ряд
До сих пор мы только генерировали метрики временных рядов в определенный момент времени. Тем не менее, легче для глаз, чтобы просмотреть совокупную сумму с течением времени.
Эти шаги берут сгенерированную таблицу time_series и используют расширяющееся окно для вычисления совокупной суммы.

📈 Пример графика с использованием выходной таблицы time_series
Приведенный ниже график временных рядов основан на наших совокупных результатах по количеству единорогов в стране. Мы видим, что с 2020-2021 годов США достигли траектории производства "единорогов", с которой не мог сравниться Китай. В то время как Индия и Великобритания, возможно, только начинают свой рост.

🧑💼 Статистика инвесторов
Генерация метрик инвестора более сложна. Инвесторы каждой компании хранятся в виде строки, разделенной запятыми.
Например, у Avant есть select_investors "RRE Ventures, Tiger Global, August Capital".
Мы хотим повторно использовать тот же формат кода, что и для метрик на уровне страны, чтобы использовать метод pandas.DataFrame.groupby. Это поможет нам провести рефакторинг позже.

🏗 Неразворотные инвесторы
Разворот является ключом к этому шаблону проектирования, так как мы хотим использовать метод groupby для отдельных инвесторов.
Используя pandas.DataFrame.explode, мы создаем дополнительный столбец для индивидуальных инвесторов. Обратите внимание, что теперь у нас есть несколько строк для каждой компании в нашей таблице.
💡 Здесь я использовалexplodeдля разворота. Еще один способ проверки:melt.
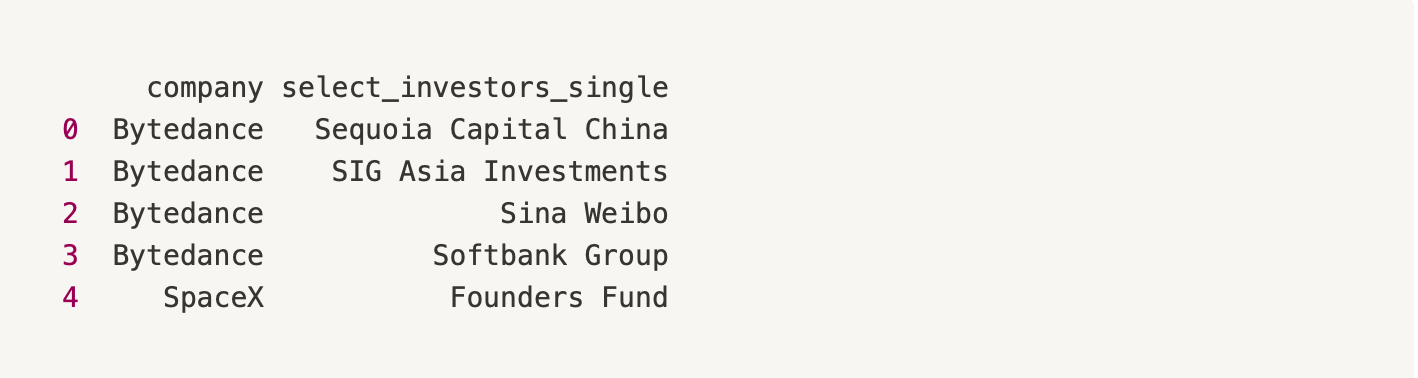
Следующим шагом является создание простой статистики инвесторов, количества компаний и оценки компаний в портфеле каждого инвестора.
📈 Пример графика с использованием investors_stats
На гистограмме ниже показано распределение инвесторов по общему количеству Единорогов в их портфеле. Мы видим распределение по степенному закону, когда у большинства инвесторов есть только 1 единорог, в то время как немногие инвестировали во многие. Этот тип распределения также можно найти в денежном богатстве населения и социальных сетях.

🔧 Трубопровод до сих пор
На данный момент у нас есть конвейер метрик, который выглядит довольно аккуратно, но всего мы генерируем только 8 метрик. Если бы мы расширили это число до 20-30 метрик, наш сценарий начал бы часто повторяться.
Формат нашего кода до сих пор представлял собой простой скрипт Python. Таким образом, наш код нельзя изолировать и протестировать.
Наш единственный вариант тестирования - запустить весь сценарий и оценить результат в сквозном тесте. Это не очень хорошо, так как это может занять много времени.
🚧 Рефакторинг конвейера
🚪Принцип открытия-закрытия
"Открыто для расширения, но закрыто для модификации".
Рефакторинг нашего кода, чтобы максимально следовать принципу открытия-закрытия.
- Переместите функции метрик в класс метрик и заручитесь использованием метода
pandas.DataFrame.apply. - Удалите повторные вызовы
pandas.DataFrame.groupbyс помощью функцииgenerate_metrics, используя встроенную в Python функциюgetattr. - Создайте файл конфигурации метрик, который передается нашей функции
generate_metrics, с метаданными, необходимыми для создания наших метрик.
💡 Ознакомьтесь с принципами дизайна SOLID здесь.
🧑🎓 Класс показателей
Перемещая наши метрики в класс, мы можем изолировать метрики и создавать модульные тесты для каждой метрики. Используя метод Pandas.DataFrame.apply, мы можем добавлять персонализированные метрики и использовать другие пакеты Python, не включенные в Pandas.
Следуя принципу открытия-закрытия, если бы мы хотели добавить показатели, мы бы создали новый класс, который наследует наш класс Metrics.
📂 Файл конфигурации
В файле конфигурации есть список метрик для каждой таблицы, которую мы хотим сгенерировать. Если мы хотим добавить или удалить метрики, изменить название и т. д., мы просто изменим файл конфигурации. Таким образом, мы не редактируем саму нашу кодовую базу.
⚙️ Создание функций метрик
Эта функция принимает наши данные Unicorn, экземпляр нашего класса Metrics и нашу конфигурацию показателей и возвращает кадр данных показателей.
Шаги:
- Использует
getattrдля создания объектаpandas.DataFrame.groupby.apply - Использует
getattrдля создания объекта метода класса Metrics (например,Metrics.count) - Вызывает объект
pandas.DataFrame.groupby.apply, передавая объект метода Metrics.
🪄 Рефакторинг конвейера
Наконец, мы подошли к нашему рефакторингу конвейера. Мы можем легко добавлять метрики в существующие таблицы, определяя новые классы метрик и добавляя их в наш файл конфигурации.
👀 Резюме
- Стандартизируйте код в нашем конвейере, чтобы использовать
pandas.DataFrame.groupby.applyдля выполнения преобразований наших данных. - Разверните данные, чтобы получить уникальные строки (для использования с
pandas.DataFrame.groupby). - Разместите метрики, которые мы хотим сгенерировать, в классе и передайте их
pandas.DataFrame.groupby.apply. - Используйте встроенную функцию Python
getattrи словарь метаданных для циклического просмотра наших метрик вместо повторных вызововpandas.DataFrame.groupby.apply.
✅ 🔀 Преимущества и недостатки
Преимущества
- Код является модульным и более управляемым для масштабирования наших показателей.
- Файл конфигурации дает нам больше гибкости для добавления и извлечения метрик, не касаясь кода.
- Легче протестировать функциональность нашего кода, так как он изолирован.
Компромиссы
- Больше кода для поддержки небольшого конвейера.
- Читабельность нашего кода была снижена.
- Сложнее отлаживать небольшой конвейер.
📚 Ресурсы
🐍 Кодовая база найдена здесь.
Сторонние библиотеки
pandas.DataFrame.explodepandas.DataFrame.groupbypandas.DataFrame.reset_indexpandas.merge- Python встроен
getattr
Want to Connect?
I'm just starting out my blogging journey. Let's Connect on Twitter!