
Основное руководство по расширению рабочего процесса Pandas

Pandas - одна из самых популярных библиотек Python для исследования и визуализации данных. Pandas предлагает множество API-интерфейсов для выполнения задач обработки данных, но при работе с большими наборами данных происходит сбой или медленные вычисления.
В этой статье мы обсудим 14 методов ускорения рабочего процесса Pandas с помощью различных методов, хаков или пакетов.
Ввод, вывод
1) Выборка
Панды загружают в оперативную память сразу весь файл, что затрудняет работу с данными большого размера, что может привести к сбоям в работе памяти. Идея состоит в том, чтобы читать только необходимые экземпляры и функции.
API read_csv() предлагает параметры nrows и usecols для фильтрации количества записей и функций соответственно.
2) Разделение
Методы выборки будут фильтровать и считывать выборку данных, но если вам нужно обработать все данные, вы можете разделить данные большого размера на фрагменты (что само по себе помещается в памяти). Теперь вы можете выполнять разработку функций, обработку данных и моделирование для каждого фрагмента данных.
3) Оптимизировать типы данных
При чтении данных Pandas автоматически определяет типы данных для каждой функции, однако типы данных не являются оптимальными и занимают больше требуемой памяти. Идея состоит в том, чтобы понизить тип данных каждой функции, соблюдая максимальные и минимальные значения функций.
Прочтите одну из моих предыдущих статей, чтобы лучше понять понижение типа данных с помощью приведения типов.
Оптимизируйте использование памяти Pandas для больших наборов данных
Эффективно используйте типы данных, чтобы предотвратить сбой памятиtowardsdatascience.com
4) Оптимизация чтения/записи
Чтение и запись больших наборов данных CSV, TXT или Excel утомительны при работе с библиотекой Pandas. Другие форматы файлов, такие как паркет, пиксель, перо и т. д., могут быть предпочтительнее, так как они требуют сравнительно меньше вычислительного времени для операций чтения и записи.

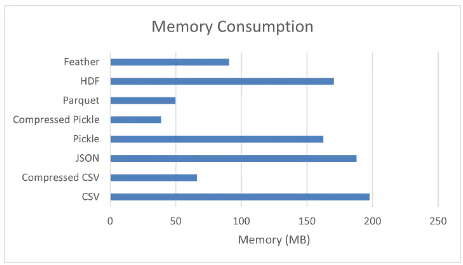
На изображении выше показаны эталонные показатели операций чтения, записи и потребления памяти для примера набора данных, содержащего 1 458 644 записи и 12 функций. Файлы Pickle можно использовать для сохранения и чтения наборов данных или временных файлов.
Прочитайте одну из моих предыдущих статей, чтобы наблюдать за сравнением производительности при использовании различных форматов данных для операций чтения и сохранения
Прекратите сохранять свой фрейм данных в формате CSV
Сравнение времени использования различных форматов данных для операций чтения и сохраненияtowardsdatascience.com
Итерация
5) Итерация с использованием Iterrows()
Iterrows() - это встроенный API Pandas, используемый для итерации фрейма данных. Iterrows() выполняет несколько вызовов функций при переборе экземпляров фрейма данных, что делает его вычислительно затратным.

Чтобы перебрать более 500 тысяч экземпляров, iterrows() занимает ~ 32 секунды со скоростью около ~ 16 тысяч итераций в секунду.
6) Итерация с использованием Itertuples()
Itertuples() - это еще один встроенный API Pandas, который перебирает фрейм данных, преобразовывая каждую строку данных в список кортежей. Itertuples() делает сравнительно меньше вызовов функций и, следовательно, несет меньше накладных расходов.
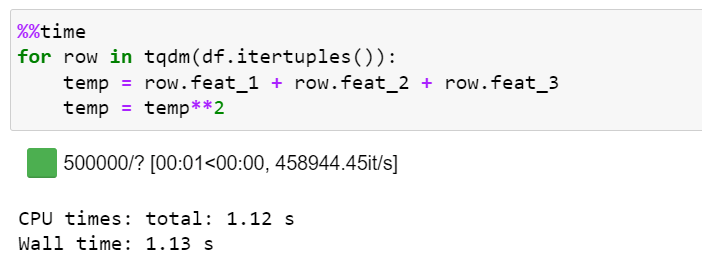
Чтобы перебрать более 500 тысяч экземпляров, itertuples() занимает ~ 1,12 секунды со скоростью около ~ 460 тысяч итераций в секунду. Это примерно в 28 раз быстрее, чем у iterrows() API.
7) Итерация по словарю
Идея состоит в том, чтобы преобразовать фрейм данных Pandas в словарь и выполнить итерацию по нему. Накладные расходы функции кадра данных Pandas теряются при повторении по словарю, но скорость вычислений улучшается по сравнению с предыдущими методами.
Панды поставляются с df.to_dict('records') функцией для преобразования фрейма данных в формат ключ-значение словаря.

Чтобы перебрать более 500 тыс. экземпляров, итерация по словарю занимает 625 мс со скоростью около ~ 830 тыс. итераций в секунду. Это примерно в 2 раза быстрее, чем у itertuples(), и примерно в 55 раз быстрее, чем у iterrows().
8) Использование приложения()
Pandas предлагает apply() API для применения или выполнения функции вдоль оси фрейма данных.

Чтобы выполнить итерацию более 500 000 экземпляров, метод apply() занимает ~18 секунд, что примерно в 2 раза быстрее, чем у API iterrows(), но медленнее, чем у других методов.
Распараллеливание
9) Многопроцессорность
В python код интерпретируется во время выполнения, а не компилируется в собственный код во время компиляции, что делает его медленнее, чем в других языках программирования.
Идея состоит в том, чтобы использовать распределенные вычисления для ускорения вычислений на всех ядрах процессора. Python предлагает многопроцессорный модуль, который позволяет выполнять такие функции.
Выполнение функций Python в 30 раз быстрее в нескольких строках кода
Основное руководство по многопроцессорной обработке в Pythontowardsdatascience.com
10) Пандараллель
Pandarellel - это инструмент с открытым исходным кодом для распараллеливания операций pandas между всеми ядрами ЦП для значительного увеличения скорости.
В простом примере использования с pandas DataFrame и функцией для применения просто замените классический apply на parallel_apply .

Чтобы выполнить итерацию более 500 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 экземпляров, методу apply() требуется ~5 секунд, что примерно в 4 раза быстрее, чем у API-интерфейса apply().

11) Модин
Modin - это многопроцессорный пакет с открытым исходным кодом и API-интерфейсами, идентичными Pandas, для ускорения рабочего процесса Pandas за счет изменения 1 строки кода. Modin предлагает ускоренную производительность примерно для 90+% API Pandas.
Модин использует Рэя и Даска под капотом для распределенных вычислений.
Пожалуйста, прочтите одну из моих предыдущих статей о Modin, чтобы понять его реализацию и возможности:
Modin - ускорьте свои записные книжки, сценарии и библиотеки Pandas
Масштабирование рабочего процесса Pandas с помощью Modin с изменением одной строки кода в сторону datascience.com
12) Даск
Dask - это пакет Python с открытым исходным кодом, который предлагает многоядерное и распределенное параллельное выполнение для наборов данных с нехваткой памяти. Он следует концепции ленивых вычислений, отображения памяти и заблокированных алгоритмов под капотом для более быстрых вычислений.
Некоторые из коллекций высокого уровня, которые предлагает Dask:
- Массивы Dask: состоят из нескольких пустых массивов, хранящихся в кусках.
- Фрейм данных Dask: состоит из нескольких фреймов данных Pandas, разбитых на фрагменты.
- Dask Bag: используется для работы с полуструктурированными или неструктурированными данными.
- Dask Delayed: параллелизация пользовательских функций и циклов.
Ниже приведены результаты сравнительного анализа для Pandas и Dask Dataframe для небольших (600 тыс. записей), средних (63 млн записей) и больших (200 млн записей) наборов данных.

13) Вэкс
Vaex - это еще один высокопроизводительный пакет Python с открытым исходным кодом, заменяющий Pandas, который использует систему выражений и сопоставление памяти, чтобы позволить разработчикам выполнять операции с наборами данных с нехваткой памяти.
Большинство Vaex фокусируется на задачах обработки и исследования данных, но охватывает очень мало API-интерфейсов Pandas.
Обработка набора данных с 200 миллионами строк с использованием Vaex
Выполнение операций с большим набором данных с использованием фрейма данных vaextowardsdatascience.com
14) Быстрее
Swifter - еще один пакет Python с открытым исходным кодом, который можно интегрировать с объектами Pandas и ускорить выполнение. Swifter автоматически определяет наилучшую стратегию реализации для ускорения объектов Pandas путем векторизации или распараллеливания с помощью Dask.

Вы можете перейти к одной из моих предыдущих статей о Swifter, в которой объясняется, как этот пакет может ускорить операции с увеличением размера данных:
Применение Pandas в 10 раз быстрее за одно изменение кода
Ускорение рабочего процесса обработки Pandas с помощью пакета Swifterв сторону datascience.com
Краткое содержание
Pandas - популярный пакет Python, используемый для задач обработки и анализа данных, но ему не хватает производительности и масштабируемости. В этой статье мы обсудили 14 хаков/методов для ускорения рабочего процесса Pandas. Все перечисленные методы достаточно удобны и просты в реализации.
Спасибо за чтение