
Что такое Big O
Big O (читается "о большое") - это способ описать, как растёт время работы алгоритма или объём используемой памяти, когда увеличиваются входные данные. Нотация не даёт секунды и миллисекунды. Она отвечает на другой вопрос: что случится, если данных станет в 10 или в 1000 раз больше.
Размер входных данных обозначают буквой n. Запись O(n) значит, что время растёт пропорционально n, а O(n^2) - что оно растёт как квадрат n. Константы и мелкие слагаемые отбрасывают: алгоритм на 3n + 10 шагов считают просто O(n).
Обычно говорят о худшем случае, то есть о самом неудачном наборе данных. Так у вас есть гарантия: быстрее заявленного оценка не обещает, а медленнее не станет.
Зачем знать сложность алгоритмов
На маленьких данных любой алгоритм работает мгновенно. Разница проявляется, когда в списке миллион элементов. Код, который на тестовых 100 записях отрабатывал за долю секунды, на реальных данных может зависнуть на минуты.
Понимание сложности помогает выбрать нужную структуру, заметить в своём коде "узкое место" и пройти собеседование, где этот вопрос задают почти всегда. Если вы ещё не знакомы с видами хранения данных, начните со статьи про структуры данных.
O(1): константное время
Время не зависит от размера данных. Доступ к элементу списка по индексу и поиск по ключу в словаре занимают одинаково мало времени и при 10, и при 10 миллионах элементов.
def first_item(items):
    return items[0]           # один шаг при любом размере списка

prices = {"хлеб": 50, "молоко": 90}
print(prices["молоко"])       # поиск по ключу: в среднем O(1)
O(n): линейное время
Время растёт пропорционально количеству элементов. Типичный пример - один проход по списку: сумма, поиск максимума, проверка наличия значения в списке.
def find_max(items):
    best = items[0]
    for x in items:           # n итераций
        if x > best:
            best = x
    return best

print(find_max([3, 9, 2, 7]))   # 9
Если элементов станет вдвое больше, цикл сделает вдвое больше шагов. Конструкция x in list тоже линейная, в отличие от x in set.
O(log n): логарифмическое время
Каждый шаг отсекает половину данных. Классика - бинарный поиск в отсортированном списке: сравниваем с серединой и отбрасываем ту половину, где искомого быть не может.
def binary_search(sorted_items, target):
    left, right = 0, len(sorted_items) - 1
    while left <= right:
        mid = (left + right) // 2
        if sorted_items[mid] == target:
            return mid
        if sorted_items[mid] < target:
            left = mid + 1     # ищем справа
        else:
            right = mid - 1    # ищем слева
    return -1

data = [1, 3, 5, 7, 9, 11, 13]
print(binary_search(data, 9))   # 4
print(binary_search(data, 4))   # -1
Для миллиона элементов хватит около 20 шагов, для миллиарда - около 30. Поэтому O(log n) считается очень быстрым. Условие одно: данные должны быть отсортированы. В стандартной библиотеке Python для этого есть модуль bisect.
O(n log n): быстрые сортировки
Такая сложность у эффективных алгоритмов сортировки: сортировки слиянием, быстрой сортировки (в среднем) и встроенной функции sorted(), которая использует алгоритм Timsort. Это лучшее, чего можно добиться для сортировки сравнением в общем случае.
numbers = [5, 2, 9, 1, 7]
print(sorted(numbers))        # [1, 2, 5, 7, 9] - O(n log n)
Про принцип работы разных сортировок можно прочитать в статье от пузырьковой сортировки к сортировке слиянием.
O(n^2): квадратичное время
Обычно возникает при вложенных циклах, когда для каждого элемента просматривают все остальные. Для 1000 элементов это уже миллион операций, для 100 000 - десять миллиардов.
def has_duplicates_slow(items):
    for i in range(len(items)):
        for j in range(i + 1, len(items)):     # цикл в цикле
            if items[i] == items[j]:
                return True
    return False

def has_duplicates_fast(items):
    return len(set(items)) != len(items)       # O(n)

print(has_duplicates_slow([1, 2, 3, 2]))   # True
print(has_duplicates_fast([1, 2, 3, 2]))   # True
Оба варианта дают одинаковый ответ, но второй работает за линейное время благодаря множеству. Часто именно замена списка на множество или словарь превращает квадратичный алгоритм в линейный.
O(2^n) и O(n!): когда всё очень плохо
Экспоненциальный рост даёт наивная рекурсия, которая многократно пересчитывает одни и те же значения. Классический пример - числа Фибоначчи.
from functools import lru_cache

def fib_slow(n):
    if n < 2:
        return n
    return fib_slow(n - 1) + fib_slow(n - 2)   # около O(2^n)

@lru_cache(maxsize=None)
def fib_fast(n):
    if n < 2:
        return n
    return fib_fast(n - 1) + fib_fast(n - 2)   # O(n) благодаря кешу

print(fib_fast(80))   # 23416728348467685
Вызов fib_slow(40) уже занимает заметное время, а fib_slow(80) не завершится за разумный срок. Кеш из functools.lru_cache запоминает результаты и убирает повторные вычисления. Сложность O(n!) возникает при переборе всех перестановок, например в задаче коммивояжёра.
Таблица типичных сложностей
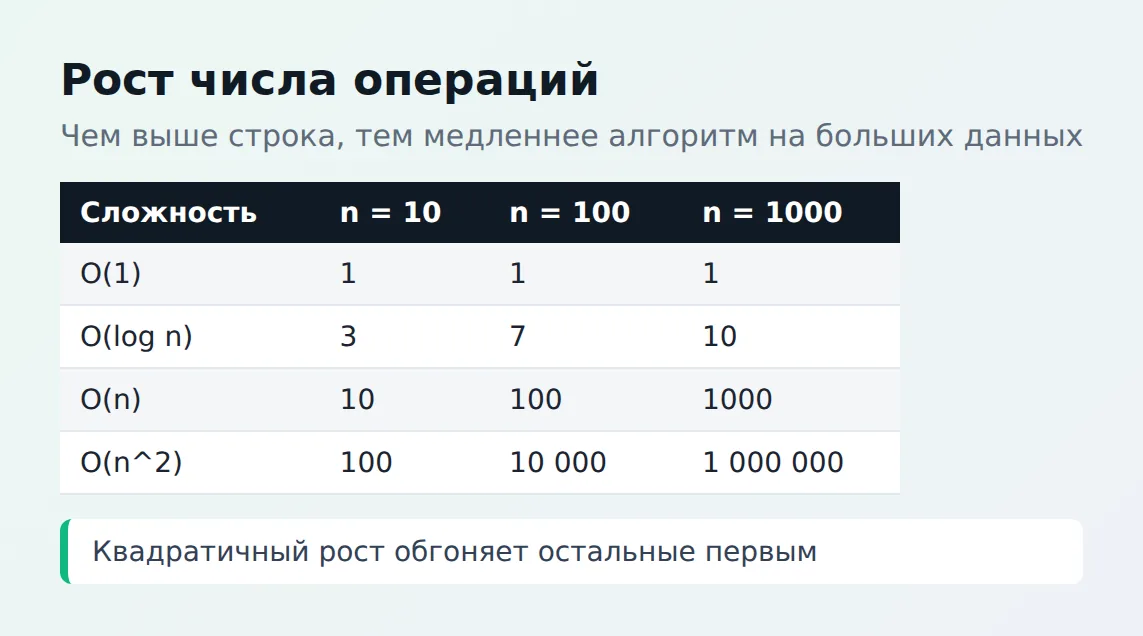
Для сравнения посмотрите, сколько примерно операций нужно при n = 1000.
| Сложность | Название | Операций при n = 1000 | Пример |
|---|---|---|---|
| O(1) | Константная | 1 | Доступ по индексу, поиск в словаре |
| O(log n) | Логарифмическая | около 10 | Бинарный поиск |
| O(n) | Линейная | 1 000 | Проход по списку |
| O(n log n) | Линеарифмическая | около 10 000 | Сортировка слиянием, sorted() |
| O(n^2) | Квадратичная | 1 000 000 | Вложенные циклы |
| O(2^n) | Экспоненциальная | больше, чем атомов во вселенной | Наивные числа Фибоначчи |
Как определить сложность своего кода
Для начала достаточно нескольких правил, которые покрывают большинство случаев.
- Одиночные операции (присваивание, арифметика, доступ по индексу) считаются O(1).
- Цикл по n элементам даёт O(n). Два цикла подряд складываются: O(n) + O(n) остаётся O(n).
- Цикл внутри цикла перемножается: n на n даёт O(n^2).
- Если на каждом шаге данные делятся пополам, это O(log n).
- Из итоговой формулы убираем константы и слабые слагаемые: O(2n + 50) превращается в O(n), а O(n^2 + n) в O(n^2).
Скрытая сложность: операции со встроенными типами тоже имеют цену. Срез items[a:b], x in list и list.insert(0, x) внутри цикла незаметно превращают алгоритм в квадратичный. Смотрите официальную таблицу сложности операций в документации Python.
Сложность по памяти и проверка на практике
Big O описывает не только время, но и память. Алгоритм, который создаёт копию списка из n элементов, использует O(n) дополнительной памяти, а тот, что хранит несколько переменных, - O(1). Часто можно обменять память на скорость, как в примере с множеством выше.
Теорию полезно проверять измерением. Для этого подходит модуль timeit.
import timeit

setup = "data = list(range(100000)); s = set(data)"
print(timeit.timeit("99999 in data", setup=setup, number=1000))   # список: O(n)
print(timeit.timeit("99999 in s", setup=setup, number=1000))      # множество: O(1)
Поиск в множестве окажется в сотни и тысячи раз быстрее, а точные числа зависят от компьютера. Закрепить тему поможет разбор задач на Python для начинающих, а дальше можно перейти к обзору алгоритмов, которые должен знать каждый разработчик. Если Python-списки вызывают вопросы, загляните в материал про списки в Python.