
Что такое NumPy и зачем он нужен
NumPy - библиотека Python для работы с числовыми массивами. Главный объект в ней - ndarray, многомерный массив, в котором все элементы имеют один тип. Именно на нём построены pandas, SciPy, scikit-learn и большая часть научного и ML-стека Python.
Обычный список Python хранит ссылки на отдельные объекты, а массив NumPy - плотный блок памяти с числами одного типа. Поэтому вычисления над массивом выполняются кодом на C и работают в десятки раз быстрее, чем цикл for по списку. Кроме того, запись становится короче: a * 2 вместо цикла.
Если вы только начинаете, сначала освойте списки в Python и функции: многие приёмы NumPy похожи на них, но работают иначе.
Как установить NumPy и подключить его
NumPy ставится через pip. Лучше делать это внутри виртуального окружения, чтобы не засорять системный Python: как его создать, написано в статье про venv. Новые версии NumPy 2.x требуют достаточно свежий Python, так что убедитесь, что у вас не устаревшая версия интерпретатора.
python -m pip install numpy
python -c "import numpy as np; print(np.__version__)"
Первая команда скачивает и ставит пакет, вторая печатает установленную версию. Если вместо версии появилась ошибка, прочитайте разбор ситуации, когда pip не является внутренней командой. Запуск через python -m pip защищает от путаницы между разными установками Python.
В коде библиотеку принято импортировать с коротким псевдонимом. Все примеры ниже используют именно его.
import numpy as npЕсли вы работаете в тетрадях, установите пакет в то же окружение, из которого запускается Jupyter Notebook, иначе импорт не найдёт библиотеку.
Создание массивов
Самый простой способ - превратить список в массив через np.array. Вложенные списки дают двумерный массив, то есть матрицу.
a = np.array([1, 2, 3, 4])
m = np.array([[1, 2, 3], [4, 5, 6]])

print(a)          # [1 2 3 4]
print(m.shape)    # (2, 3)  - 2 строки, 3 столбца
print(m.ndim)     # 2       - число осей
print(m.size)     # 6       - всего элементов
Атрибут shape - кортеж с размерами по каждой оси, ndim - число осей. Эти два значения вы будете проверять чаще всего, когда ищете ошибку в вычислениях.
Для типовых заготовок есть готовые функции, которые не требуют перечислять элементы вручную.
| Функция | Что создаёт | Пример результата |
|---|---|---|
np.zeros((2, 3)) | Массив из нулей | матрица 2 на 3 из 0. |
np.ones(4) | Массив из единиц | [1. 1. 1. 1.] |
np.full((2, 2), 7) | Массив с одним значением | матрица 2 на 2 из семёрок |
np.arange(0, 10, 2) | Числа с шагом, как range | [0 2 4 6 8] |
np.linspace(0, 1, 5) | Заданное число точек на отрезке, конец включён | [0. 0.25 0.5 0.75 1.] |
np.eye(3) | Единичная матрица | 1 на диагонали, остальное 0 |
np.empty(3) | Массив без инициализации | случайный мусор из памяти |
Разница между arange и linspace в том, что первая задаётся шагом, а вторая - количеством точек. Для дробных шагов надёжнее linspace: у arange из-за округления конец диапазона иногда получается неожиданным.
Для случайных чисел используйте генератор: он создаётся один раз, а значения берутся его методами. Начальное число (seed) делает результат повторяемым.
rng = np.random.default_rng(42)
x = rng.random(3)             # три числа от 0 до 1
d = rng.integers(1, 7, size=5)  # пять "бросков кубика" от 1 до 6
print(x.shape, d.shape)       # (3,) (5,)
Старые примеры в сети часто используют np.random.rand и np.random.seed. Они работают, но современный подход - default_rng.
Типы данных dtype
У каждого массива есть тип элементов, он хранится в атрибуте dtype. NumPy выбирает его сам по содержимому, но тип можно задать явно.
a = np.array([1, 2, 3])
b = np.array([1.5, 2, 3])
c = np.array([1, 2, 3], dtype=np.float32)

print(a.dtype)   # int64 (на большинстве систем)
print(b.dtype)   # float64 - один дробный элемент делает всё дробным
print(c.dtype)   # float32

d = a.astype(np.float64)   # astype возвращает копию с новым типом
print(d)                   # [1. 2. 3.]
Список самых нужных типов небольшой. Остальные пригодятся, когда вы начнёте экономить память или читать бинарные файлы.
| dtype | Описание | Когда использовать |
|---|---|---|
int64 | Целые, 8 байт | счётчики, индексы |
float64 | Дробные двойной точности | по умолчанию для вычислений |
float32 | Дробные одинарной точности | большие массивы, нейросети, экономия памяти |
uint8 | Целые от 0 до 255 | пиксели изображений |
bool | Истина или ложь | маски и условия |
Целые типы NumPy не расширяются сами: np.uint8(250) + np.uint8(10) переполнится и даст 4, а не 260. Если складываете много значений небольшого типа, сначала приведите массив через astype к более широкому.
Индексация и срезы
Для одномерного массива индексы работают как в списке: отсчёт с нуля, отрицательные индексы считаются с конца, срез записывается как начало:конец:шаг. Для двумерного через запятую указываются строка и столбец.
m = np.array([[10, 11, 12],
              [20, 21, 22],
              [30, 31, 32]])

print(m[0, 1])      # 11 - строка 0, столбец 1
print(m[1])         # [20 21 22] - вся строка
print(m[:, 2])      # [12 22 32] - весь столбец
print(m[0:2, 1:])   # [[11 12]
                    #  [21 22]]
print(m[::-1, 0])   # [30 20 10] - первый столбец в обратном порядке
Двоеточие означает "все элементы по этой оси". Запись m[:, 2] читается как "все строки, столбец с индексом 2".
Главное отличие от списков: срез NumPy - это не копия, а представление (view) тех же данных. Изменение среза меняет исходный массив.
a = np.arange(6)       # [0 1 2 3 4 5]
s = a[1:4]
s[0] = 99
print(a)               # [ 0 99  2  3  4  5] - исходный массив изменился

b = a[1:4].copy()      # явная независимая копия
b[0] = -1
print(a)               # [ 0 99  2  3  4  5] - теперь без изменений
Булевы маски и индексация списком
Условие над массивом возвращает массив из True и False. Если подставить его в квадратные скобки, вы получите только подходящие элементы. Это один из самых полезных приёмов библиотеки.
t = np.array([18, 25, 31, 12, 40])

mask = t > 20
print(mask)          # [False  True  True False  True]
print(t[mask])       # [25 31 40]
print(t[(t > 20) & (t < 35)])   # [25 31]

t[t < 15] = 0        # заменить все значения меньше 15 на ноль
print(t)             # [18 25 31  0 40]

print(t[[0, 2, 4]])  # [18 31 40] - выбор по списку индексов
Для объединения условий используйте &, | и ~ и заключайте каждое условие в скобки. Обычные and и or здесь не работают и вызовут ошибку о неоднозначности истинности массива. В отличие от срезов, индексация маской или списком всегда возвращает копию.
Операции над массивами и векторизация
Арифметика в NumPy выполняется поэлементно. Не нужно писать цикл: операция применяется сразу ко всему массиву. Такой стиль называют векторизацией.
a = np.array([1, 2, 3])
b = np.array([10, 20, 30])

print(a + b)      # [11 22 33]
print(a * b)      # [10 40 90] - поэлементное, а не матричное умножение
print(a ** 2)     # [1 4 9]
print(np.sqrt(a)) # [1.         1.41421356 1.73205081]
print(a @ b)      # 140 - скалярное произведение (оператор @)
Обратите внимание: * перемножает элементы попарно. Матричное умножение записывается оператором @ или функцией np.matmul.
Сравним векторизованный код с циклом на задаче "сумма квадратов чисел от 0 до 999999".
import time
import numpy as np

n = 1_000_000

start = time.perf_counter()
total = 0
for i in range(n):
    total += i * i
print("цикл:", time.perf_counter() - start)

start = time.perf_counter()
arr = np.arange(n, dtype=np.int64)
total_np = int((arr * arr).sum())
print("numpy:", time.perf_counter() - start)

print(total == total_np)   # True
Точные секунды зависят от компьютера, но NumPy-вариант обычно быстрее в десятки раз. Последняя строка проверяет, что результаты совпадают. Причём тип int64 указан явно: на Windows с некоторыми старыми версиями по умолчанию мог использоваться 32-битный тип, и сумма бы переполнилась.
Если интересно, почему цикл по миллиону элементов считается медленно и как оценивать такие вещи, посмотрите статью про нотацию Big O.
Агрегирующие функции и оси
Методы sum, mean, min, max, std работают как по всему массиву, так и вдоль выбранной оси. Ось 0 - это движение по строкам (вычисляется по каждому столбцу), ось 1 - по столбцам (вычисляется по каждой строке).
m = np.array([[1, 2, 3],
              [4, 5, 6]])

print(m.sum())          # 21 - по всему массиву
print(m.sum(axis=0))    # [5 7 9] - сумма по каждому столбцу
print(m.sum(axis=1))    # [ 6 15] - сумма по каждой строке
print(m.mean(axis=1))   # [2. 5.]
print(m.argmax())       # 5 - индекс максимума в сплющенном массиве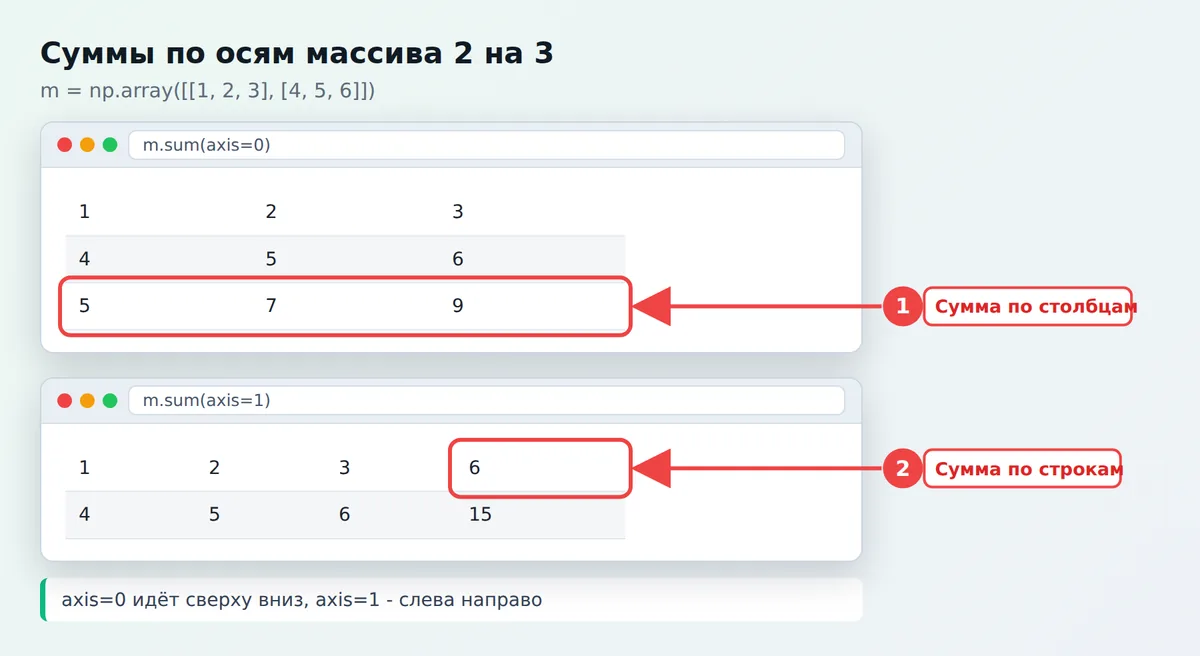
Broadcasting: как складывать массивы разной формы
Broadcasting (транслирование) позволяет выполнять операции над массивами разных форм, не копируя данные вручную. NumPy сравнивает формы справа налево, и две оси совместимы, если их размеры равны или один из них равен 1. Ось размера 1 растягивается до размера другой.
m = np.array([[1, 2, 3],
              [4, 5, 6]])     # форма (2, 3)

row = np.array([10, 20, 30])  # форма (3,)
col = np.array([[100],
                [200]])       # форма (2, 1)

print(m + row)
# [[11 22 33]
#  [14 25 36]]

print(m + col)
# [[101 102 103]
#  [204 205 206]]

print(m * 2)                  # число тоже транслируется
В первом случае строка из трёх чисел прибавляется к каждой строке матрицы, во втором столбец из двух чисел прибавляется к каждому столбцу. Если формы несовместимы, NumPy сообщит об ошибке вида operands could not be broadcast together.
Типичное применение - нормализация данных: вычесть среднее и поделить на отклонение по каждому столбцу без единого цикла.
data = np.array([[1.0, 200.0],
                 [2.0, 300.0],
                 [3.0, 400.0]])

norm = (data - data.mean(axis=0)) / data.std(axis=0)
print(norm.mean(axis=0))   # значения около 0
print(norm.std(axis=0))    # [1. 1.]
Здесь data.mean(axis=0) имеет форму (2,), и NumPy автоматически растягивает её на все три строки.
Изменение формы и склейка массивов
Метод reshape меняет форму, не меняя данные, при условии что общее число элементов совпадает. Одно из измерений можно заменить на -1, и NumPy вычислит его сам.
a = np.arange(12)
m = a.reshape(3, 4)
print(m.shape)               # (3, 4)
print(a.reshape(2, -1).shape)  # (2, 6)
print(m.T.shape)             # (4, 3) - транспонирование
print(m.flatten().shape)     # (12,)

x = np.array([1, 2, 3])
y = np.array([4, 5, 6])
print(np.concatenate([x, y]))   # [1 2 3 4 5 6]
print(np.vstack([x, y]))        # [[1 2 3]
                                #  [4 5 6]]
reshape и транспонирование обычно возвращают представление, а flatten - всегда копию. Для склейки по горизонтали есть np.hstack, по вертикали - np.vstack, а универсальная функция - np.concatenate с параметром axis.
NumPy и pandas
Столбцы таблиц в pandas хранятся как массивы NumPy, поэтому почти всё из этой статьи переносится на данные: маски, агрегаты, векторные операции. Любую колонку можно получить как массив через .to_numpy(). Если следующий шаг для вас - таблицы и CSV, переходите к статье про pandas для начинающих.
Для хранения и обмена данными массивы можно сохранить на диск.
np.save("data.npy", np.arange(5))   # бинарный формат NumPy
loaded = np.load("data.npy")
print(loaded)                       # [0 1 2 3 4]

np.savetxt("data.csv", np.array([[1, 2], [3, 4]]), delimiter=",", fmt="%d")
print(np.loadtxt("data.csv", delimiter=",", dtype=int))
Формат .npy сохраняет тип и форму, текстовый CSV удобен для просмотра, но теряет тип.
Частые ошибки новичков
- Цикл
forпо элементам массива вместо векторной операции. Если нужно применить действие ко всем числам, ищите готовую функцию или операцию. - Ожидание копии от среза. Изменили срез - изменился исходный массив. Нужна независимая копия - вызывайте
.copy(). - Путаница
*и@. Первое умножает поэлементно, второе - матрично. - Одномерный массив формы (3,) - не то же самое, что столбец (3, 1). Для превращения в столбец используйте
a[:, np.newaxis]илиa.reshape(-1, 1). - Смешение типов в одном массиве. Строка в списке превращает все числа в строки:
np.array([1, "a"])даст массив строк. - Использование
andвместо&в масках.
Когда базовые приёмы освоены, полезно закреплять их на практике: подойдут задачи на Python с решениями, где часть решений можно переписать через массивы. Если интересно, как данные организованы в памяти в целом, прочитайте про структуры данных.