
Что такое структуры данных
Структура данных - это способ хранить набор значений так, чтобы с ними удобно и быстро работать. Список покупок, очередь в кассу, телефонная книга, карта метро - всё это разные структуры, и у каждой свои сильные стороны.
От выбора структуры зависит скорость программы и простота кода. Искать имя в неупорядоченном списке из миллиона записей долго, а в словаре практически мгновенно. Поэтому структуры данных изучают вместе с алгоритмами: одно без другого бесполезно.
Ниже разберём основные виды: массив и список, стек, очередь, хеш-таблицу (словарь и множество), дерево и граф. Примеры на Python, потому что в нём почти всё нужное есть из коробки.
Классификация: линейные и нелинейные
Структуры обычно делят на две группы. В линейных элементы идут друг за другом, у каждого есть предыдущий и следующий: массив, список, стек, очередь. В нелинейных связи сложнее: у дерева элемент может иметь несколько потомков, в графе связей между элементами может быть сколько угодно.
Отдельно выделяют ассоциативные структуры, где значение ищут не по номеру, а по ключу: словарь и множество. Они реализованы через хеш-таблицу.
| Структура | Тип | Типичное применение |
|---|---|---|
| Массив, список | Линейная | Хранение последовательности, доступ по номеру |
| Стек | Линейная | Отмена действий, разбор скобок, вызовы функций |
| Очередь | Линейная | Задачи по порядку, обход в ширину |
| Хеш-таблица | Ассоциативная | Поиск по ключу, подсчёт, уникальные значения |
| Дерево | Нелинейная | Файловая система, иерархии, быстрый поиск |
| Граф | Нелинейная | Карты, соцсети, маршруты |
Массив и список
Массив хранит элементы подряд в памяти, поэтому обратиться к элементу по номеру можно мгновенно. Вставка в начало или середину дороже: все последующие элементы приходится сдвигать.
В Python роль массива играет список list. Он динамический: может расти и хранить значения разных типов. Подробнее о методах и срезах написано в статье про списки в Python.
nums = [10, 20, 30]
nums.append(40)        # добавить в конец - быстро
nums.insert(0, 5)      # вставка в начало - медленно, сдвигает всё
print(nums[2])         # доступ по индексу - быстро: 20
print(30 in nums)      # поиск перебором: True
Для компактного хранения чисел есть модуль array и библиотека NumPy, но для старта хватает обычного списка.
Отдельно упомянем связный список: каждый элемент хранит значение и ссылку на следующий. Вставка в известное место быстрая, но к нужному элементу приходится идти с начала. В Python его пишут редко, и в основном на собеседованиях.
Стек: последним пришёл - первым ушёл
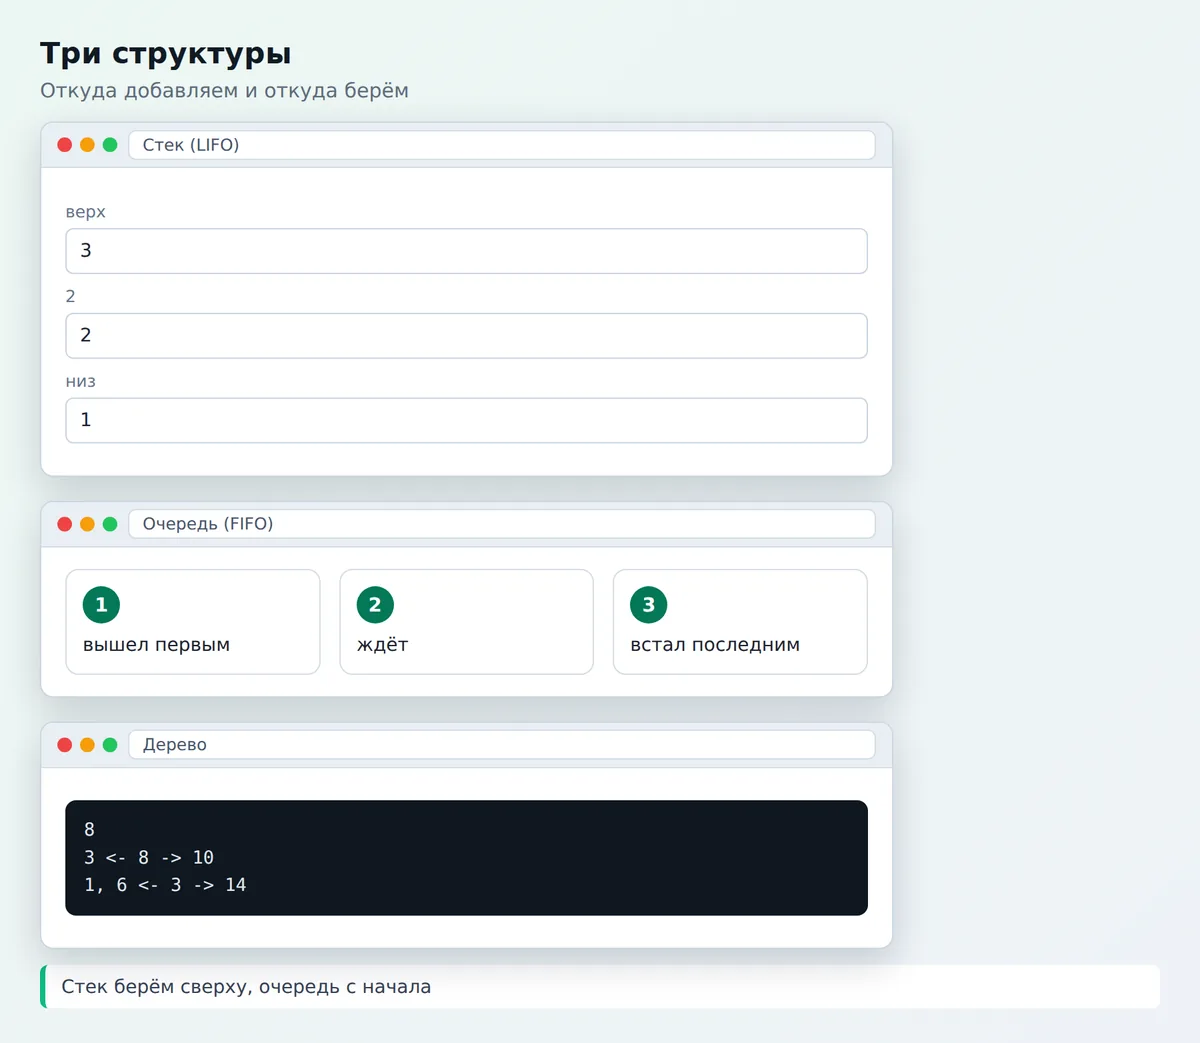
Стек работает как стопка тарелок: кладёте сверху и берёте сверху. Принцип называют LIFO. Так устроены кнопка "Назад" в браузере, отмена действия в редакторе и стек вызовов функций.
stack = []
stack.append("страница 1")
stack.append("страница 2")
stack.append("страница 3")
print(stack.pop())    # страница 3 - последняя добавленная
print(stack)          # ['страница 1', 'страница 2']
Список отлично подходит для стека, потому что append и pop с конца работают быстро. Подробный разбор есть в переводе про структуру данных стека и её применение.
Очередь: первым пришёл - первым ушёл
Очередь работает как в магазине: кто раньше встал, того раньше обслужат (FIFO). Её используют для обработки задач по порядку, печати документов, сообщений в брокерах.
Список для очереди не годится: удаление из начала сдвигает все элементы. Правильный выбор - collections.deque, где операции с обоих концов быстрые.
from collections import deque

queue = deque()
queue.append("задача A")
queue.append("задача B")
queue.append("задача C")
print(queue.popleft())   # задача A - вышла первой
print(len(queue))        # 2
Частая ошибка: делать очередь на обычном списке через pop(0). На маленьких данных незаметно, на сотнях тысяч элементов программа начинает заметно тормозить. Берите deque.
Хеш-таблица: словарь и множество
Хеш-таблица превращает ключ в число (хеш) и по нему сразу находит место хранения. Поэтому поиск, добавление и удаление в среднем занимают одинаковое короткое время независимо от размера. В Python это dict и set.
phones = {"Анна": "+7 900 111-11-11", "Борис": "+7 900 222-22-22"}
phones["Вера"] = "+7 900 333-33-33"
print(phones["Анна"])           # поиск по ключу
print("Борис" in phones)        # True

words = ["да", "нет", "да", "может", "нет", "да"]
counts = {}
for w in words:
    counts[w] = counts.get(w, 0) + 1
print(counts)                   # {'да': 3, 'нет': 2, 'может': 1}

unique = set(words)             # множество: без повторов
print(unique)
Ключом словаря может быть только неизменяемый объект: строка, число, кортеж. Список ключом быть не может. Множество удобно для проверки "есть ли значение", удаления дублей и операций пересечения и объединения.
В худшем случае при множестве коллизий операции замедляются до линейного времени, но с хорошей хеш-функцией такое встречается редко.
Дерево
Дерево состоит из узлов: у верхнего (корня) есть потомки, у тех свои, и так далее. Без циклов. Файловая система, структура HTML-страницы, оглавление - всё это деревья.
Популярный вариант - двоичное дерево поиска: у каждого узла не больше двух потомков, слева значения меньше, справа больше. Поиск в нём занимает время порядка логарифма от размера, если дерево сбалансировано.
class Node:
    def __init__(self, value):
        self.value = value
        self.left = None
        self.right = None

def insert(node, value):
    if node is None:
        return Node(value)
    if value < node.value:
        node.left = insert(node.left, value)
    else:
        node.right = insert(node.right, value)
    return node

def inorder(node):                      # обход слева направо
    if node:
        yield from inorder(node.left)
        yield node.value
        yield from inorder(node.right)

root = None
for v in [8, 3, 10, 1, 6, 14]:
    root = insert(root, v)
print(list(inorder(root)))              # [1, 3, 6, 8, 10, 14]
Обход дерева слева направо выдаёт значения по возрастанию. Класс Node здесь - маленький пример объектно-ориентированного подхода: данные узла и связи хранятся в объекте.
Граф
Граф - набор вершин и рёбер между ними. Города и дороги, люди и дружба, страницы и ссылки. В отличие от дерева, здесь допустимы циклы, а рёбра могут быть направленными.
Самый простой способ хранить граф в Python - словарь, где ключ - вершина, а значение - список соседей. Для обхода в ширину нужна как раз очередь.
from collections import deque

graph = {
    "A": ["B", "C"],
    "B": ["D"],
    "C": ["D"],
    "D": [],
}

def bfs(graph, start):
    seen = {start}
    queue = deque([start])
    order = []
    while queue:
        v = queue.popleft()
        order.append(v)
        for neighbor in graph[v]:
            if neighbor not in seen:
                seen.add(neighbor)
                queue.append(neighbor)
    return order

print(bfs(graph, "A"))   # ['A', 'B', 'C', 'D']
Обратите внимание, что в одном алгоритме сразу три структуры: словарь для графа, множество для посещённых вершин и очередь для порядка обхода. Так и выглядит реальная работа со структурами данных.
Сложность операций и выбор структуры
Чтобы сравнивать структуры, используют нотацию Big O: она показывает, как растёт время операции с ростом данных. Подробно она объяснена в статье про нотацию Big O. Ниже типичные значения для встроенных типов Python по официальной таблице сложности (для словаря и множества приведены средние значения).
| Операция | list | deque | dict | set |
|---|---|---|---|---|
| Доступ по индексу или ключу | O(1) | O(n) в середине | O(1) | - |
| Добавление в конец | O(1) | O(1) | O(1) | O(1) |
| Вставка или удаление в начале | O(n) | O(1) | - | - |
| Проверка "есть ли элемент" | O(n) | O(n) | O(1) | O(1) |
| Удаление по значению или ключу | O(n) | O(n) | O(1) | O(1) |
Как выбирать на практике:
- Нужен порядок и доступ по номеру - список.
- Нужно часто брать из начала -
deque. - Нужно быстро искать по ключу или подсчитывать - словарь.
- Нужно убрать дубли или проверять принадлежность - множество.
- Данные вложены друг в друга - дерево, а связи произвольные - граф.
Если хотите пойти дальше, посмотрите перевод про изучение структур данных и алгоритмов и обзор 10 алгоритмов, которые должен знать каждый разработчик.