
Несмотря на то, что существует множество статей, объясняющих, как развернуть модель YOLOv5, в большинстве из них не выполняется предварительная обработка (изменение размера и дополнение) изображений должным образом. Хотя YOLO предоставляет пример сценария для развертывания, если вам просто нужна чистая минимальная реализация, которая работает с OpenCV, вам придется копаться в коде, чтобы получить то, что вам нужно.
К счастью, я уже сделал это за вас, и весь код, который вам нужен, будет в этой статье.
Примечание. Хотя ваша модель может работать достаточно хорошо даже с неправильной предварительной обработкой, если вы хотите добиться той же точности тестирования/проверки, которую вы получили во время обучения, вы должны подготовить изображения точно так, как ожидает модель.
Распространенные ошибки
1. Прямое изменение размера
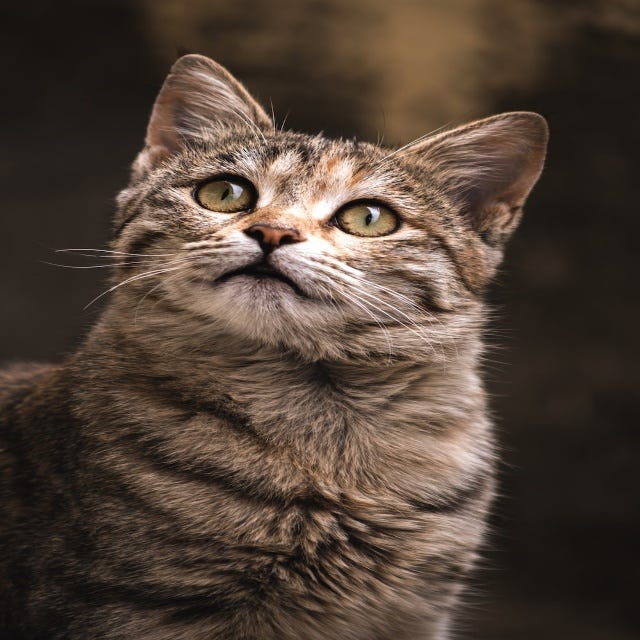
Из того, что я видел, многие люди просто напрямую изменяют размер изображения до формы, на которой была обучена модель. Если ваши изображения не имеют соотношение сторон 1:1 ( ширина = высота ), это означает, что вы либо сожмете, либо растянете изображение в одном из направлений, что приведет к недоступности функций, которые, скорее всего, повредят. производительность.
2. Асимметричное заполнение
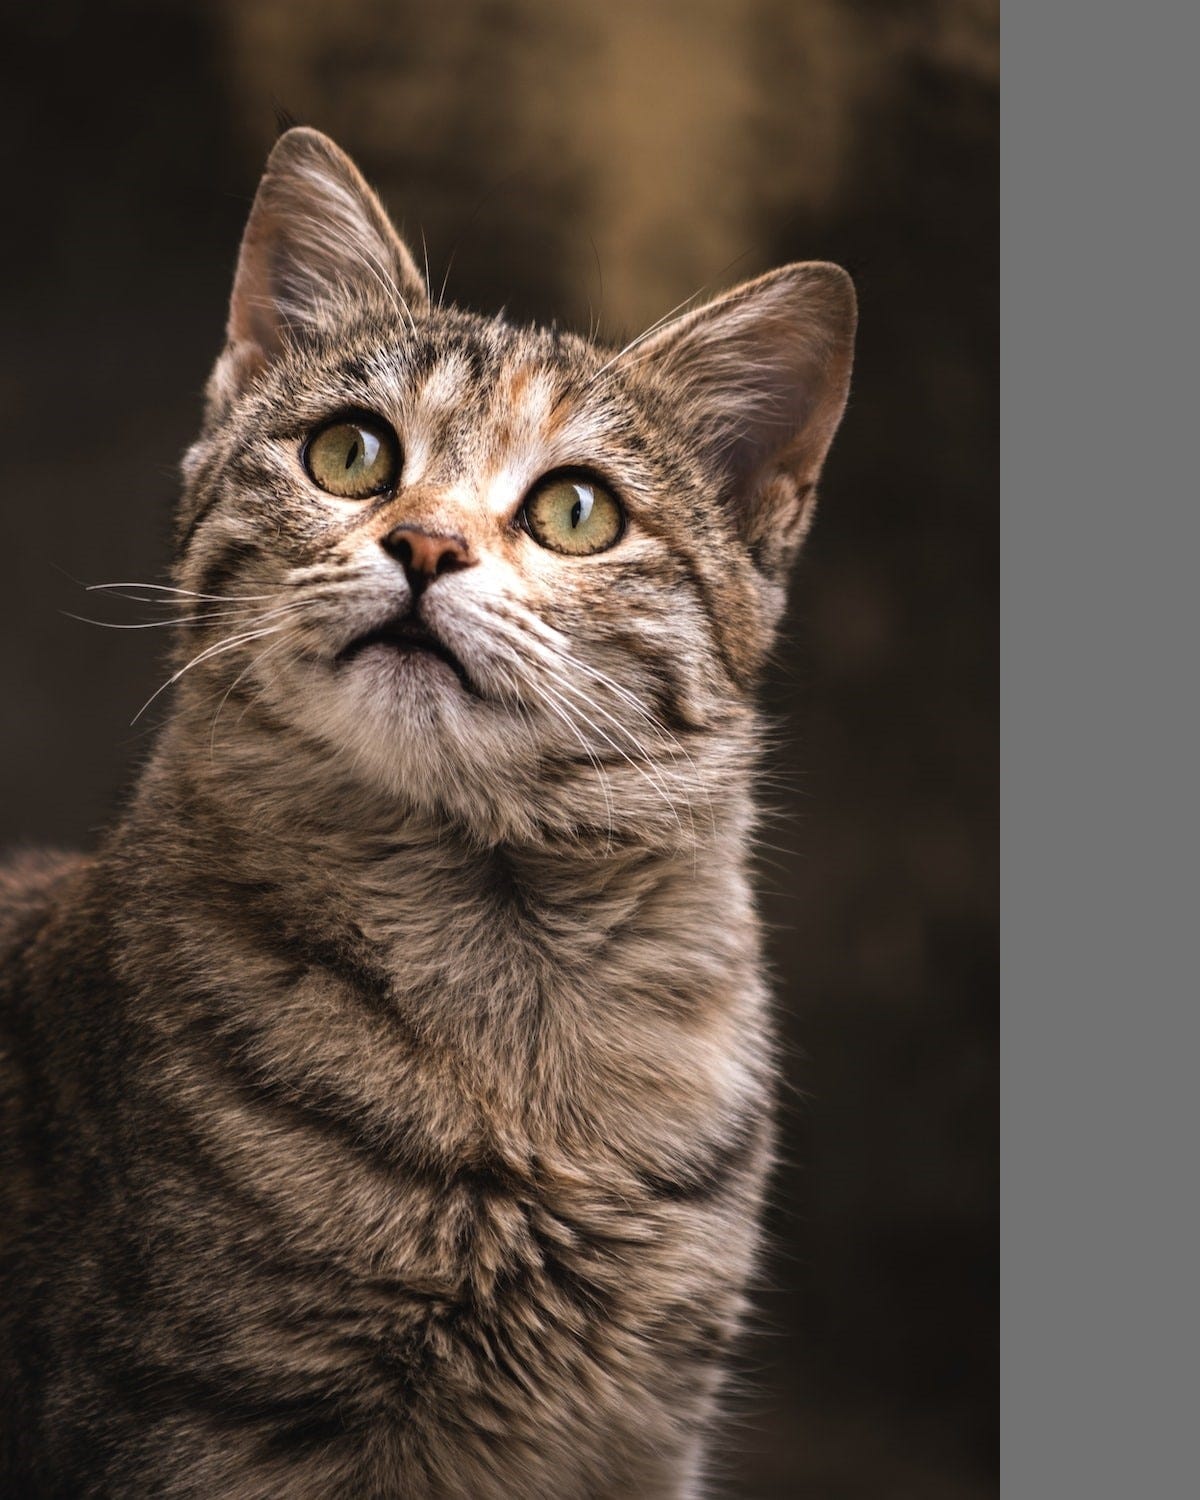
Еще одна распространенная ошибка - заполнение только одной стороны изображения. Хотя это не тормозит никаких геометрических функций, оно по-прежнему будет создавать изображения, на которых ваша модель не обучалась. По моему опыту, это обычно влияет на меньшие модели YOLOv5.
Решение
Основная идея заключается в том, что мы хотим изменить размер изображения, не нарушая его исходное соотношение сторон, а затем симметрично заполнить меньший размер с обеих сторон.
Ниже вы можете найти код OpenCV для этого:
Шаг 1 Прочитайте изображение
img = cv2.imread("cat.jpg")
Шаг 2 (применяется только в том случае, если вы тренировались на изображениях в градациях серого)
# Convert image to grayscale
im = cv2.cvtColor(im0, cv2.COLOR_BGR2GRAY)
# Stack 3 copies of the same channels to create 3 channels
im = cv2.merge((im,im,im))
Шаг 3. Измените размер, сохранив соотношение сторон.
shape = im.shape[:2]  # current shape [height, width]
new_shape = (640, 640) # the shape the model was trained with

# Scale ratio (new / old).
# We take the min to maintain aspect ratio.
# The smaller side will be padded later
r = min(new_shape[0] / shape[0], new_shape[1] / shape[1])

ratio = r, r  # width, height ratios
new_unpad = int(round(shape[1] * r)), int(round(shape[0] * r))

# Resize the image
im = cv2.resize(im, new_unpad, interpolation=cv2.INTER_LINEAR)
Шаг 4. Пэд
# color used for padding
color = (114, 114, 114)
dw, dh = new_shape[1] - new_unpad[0], new_shape[0] - new_unpad[1]  # wh padding

# divide padding into 2 sides
dw /= 2
dh /= 2

 # compute padding on all corners
top, bottom = int(round(dh - 0.1)), int(round(dh + 0.1))
left, right = int(round(dw - 0.1)), int(round(dw + 0.1))
im = cv2.copyMakeBorder(im, top, bottom, left, right, cv2.BORDER_CONSTANT, value=color)  # add border
Если вам интересно, почему мы сначала не дополняем, а затем не изменяем размер, ответ прост: быстрее дополнить меньшее изображение, чем большее.
Вот и все... Если эта короткая статья оказалась вам полезной, вы можете подписаться на меня для получения аналогичного контента.
Предложения по подаче заявок на Mlearning.ai
Как стать писателем на Mlearning.aimedium.com