
Как устроено кодирование Base64
Компьютер хранит данные байтами, а байт - это 8 бит. Многие текстовые каналы (письмо, JSON, URL, заголовок HTTP) рассчитаны только на печатные символы, и произвольные байты в них портятся или вызывают ошибки. Base64 переписывает любые байты алфавитом из 64 безопасных символов.
Алфавит стандартного Base64 состоит из латинских букв A-Z (значения 0-25), a-z (26-51), цифр 0-9 (52-61) и двух знаков + (62) и / (63). Шестьдесят четыре символа - это ровно 6 бит на символ, потому что 2 в шестой степени равно 64.
Алгоритм работает группами. Берутся 3 байта (24 бита), перекладываются в четыре порции по 6 бит, и каждая порция заменяется символом алфавита по номеру. На три байта данных получается четыре символа, поэтому текст в Base64 примерно на треть (на 33%) длиннее исходных данных.
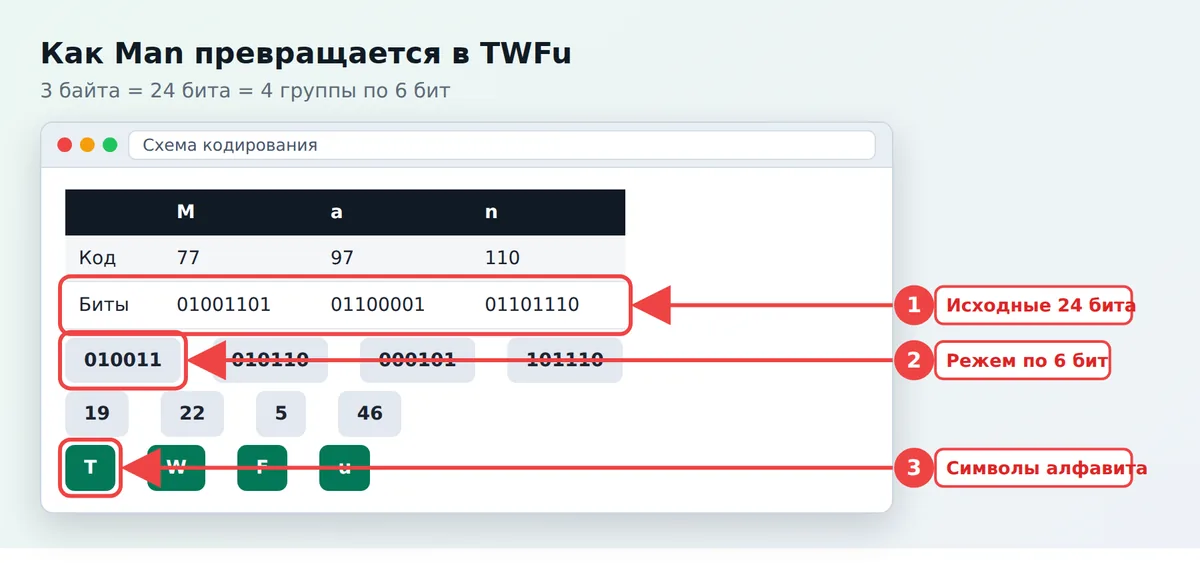
Ручное кодирование слова Man
Разберём короткий пример. Слово Man в ASCII состоит из трёх байтов, поэтому подходит ровно под одну группу. Посмотрите, как биты перераспределяются.
| Шаг | Что делаем | Результат |
|---|---|---|
| 1 | Коды символов M, a, n | 77, 97, 110 |
| 2 | Те же коды в двоичном виде | 01001101 01100001 01101110 |
| 3 | Склеиваем 24 бита и режем по 6 | 010011 010110 000101 101110 |
| 4 | Переводим порции в числа | 19, 22, 5, 46 |
| 5 | Ищем символы в алфавите | T, W, F, u |
Итог кодирования: Man превращается в TWFu. Раскодирование идёт в обратную сторону: каждый символ даёт 6 бит, четыре символа дают 24 бита, которые режутся на три байта.
Зачем нужен знак равенства в конце
Если длина данных не кратна трём, последняя группа получается неполной. Недостающие биты добиваются нулями, а в конце строки ставится знак =, чтобы длина результата стала кратна четырём.
- Остался 1 байт: он даёт два символа и два знака
==. Например,Mпревращается вTQ==. - Остались 2 байта: они дают три символа и один знак
=. Например,Maпревращается вTWE=. - Длина кратна трём: никакого дополнения нет, как в примере
TWFu.
Знак = не несёт данных, он только сообщает декодеру, сколько байтов в последней группе. Поэтому по числу знаков равенства в конце строки сразу видно, что исходные данные были не кратны трём байтам.
Base64 и base64url: в чём разница
Символы + и / в адресах и именах файлов имеют особый смысл: плюс превращается в пробел, а слэш разделяет части пути. Для таких случаев в RFC 4648 описан вариант base64url, где они заменены.
| Параметр | Base64 | base64url |
|---|---|---|
| Символ 62 | + | - |
| Символ 63 | / | _ |
Знак = в конце | обязателен | часто убирают |
| Где встречается | письма, data URI, сертификаты | токены JWT, ссылки, имена файлов |
Байты 251, 255, 191 в обычном Base64 дают +/+/, а в base64url - -_-_. Если декодер получает строку из токена без знаков равенства, перед раскодированием их нужно вернуть до длины, кратной четырём.
Кодирование и декодирование в Python
В стандартной библиотеке есть модуль base64. Он работает с байтами, поэтому строку сначала переводят в байты методом encode, а результат превращают обратно в строку через decode. Подробнее о работе с текстом в статье про методы строк Python.
import base64

text = "Привет"

# строка -> байты UTF-8 -> Base64
encoded = base64.b64encode(text.encode("utf-8")).decode("ascii")
print(encoded)

# Base64 -> байты -> строка
decoded = base64.b64decode(encoded).decode("utf-8")
print(decoded)

# вариант для URL и токенов
print(base64.urlsafe_b64encode(b"Hello, World!").decode("ascii"))
Скрипт выведет 0J/RgNC40LLQtdGC, затем слово Привет, затем SGVsbG8sIFdvcmxkIQ==. Если передать в b64encode обычную строку, Python вернёт ошибку TypeError: функция принимает только байты.
Файлы кодируют так же, только читают их в двоичном режиме.
import base64

with open("photo.png", "rb") as f:
    data = base64.b64encode(f.read()).decode("ascii")

# готовая строка для вставки в HTML или CSS
uri = "data:image/png;base64," + data
print(uri[:60])
Префикс data:image/png;base64, превращает строку в data URI: браузер показывает картинку без отдельного запроса к серверу. Для больших файлов этот приём невыгоден, ведь размер вырастает на треть и страница не кэширует картинку отдельно.
Base64 в JavaScript: btoa, atob и UTF-8
В браузере есть функции btoa (кодирует) и atob (декодирует). С английским текстом они работают сразу, но символы вне диапазона Latin-1 вызывают ошибку.
console.log(btoa("Hello"));      // SGVsbG8=
console.log(atob("SGVsbG8="));   // Hello

// btoa("Привет") выбросит InvalidCharacterError
Чтобы закодировать кириллицу, сначала превращаем текст в байты UTF-8 через TextEncoder, затем собираем из байтов строку и отдаём её в btoa. При декодировании шаги идут в обратном порядке. Про саму кодировку читайте в статье про кодировку UTF-8.
function toBase64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  bytes.forEach((b) => { binary += String.fromCharCode(b); });
  return btoa(binary);
}

function fromBase64(b64) {
  const binary = atob(b64);
  const bytes = Uint8Array.from(binary, (c) => c.charCodeAt(0));
  return new TextDecoder().decode(bytes);
}

console.log(toBase64("Привет"));              // 0J/RgNC40LLQtdGC
console.log(fromBase64("0J/RgNC40LLQtdGC"));  // Привет
В Node.js удобнее класс Buffer: он сразу работает с UTF-8 и поддерживает вариант base64url.
const enc = Buffer.from("Привет", "utf8").toString("base64");
console.log(enc);                                    // 0J/RgNC40LLQtdGC
console.log(Buffer.from(enc, "base64").toString("utf8"));
console.log(Buffer.from("Hello, World!").toString("base64url"));
Данные в формате JSON тоже иногда хранят в Base64, например вложения в ответах API. О самом формате есть статья JSON: что это такое.
Base64 в командной строке
В Linux и macOS есть утилита base64. Флаг -n у echo нужен, чтобы в данные не попал перевод строки, иначе результат изменится.
echo -n "Hello, World!" | base64
# SGVsbG8sIFdvcmxkIQ==

echo "SGVsbG8sIFdvcmxkIQ==" | base64 --decode
# Hello, World!

base64 photo.png > photo.b64
base64 -w 0 photo.png      # GNU-версия: одной строкой без переносов
GNU-версия утилиты по умолчанию переносит строку каждые 76 символов, флаг -w 0 отключает перенос. Другие команды терминала описаны в статье основные команды Linux.
В Windows PowerShell тот же результат даёт .NET.
$bytes = [System.Text.Encoding]::UTF8.GetBytes("Привет")
[Convert]::ToBase64String($bytes)

$back = [Convert]::FromBase64String("0J/RgNC40LLQtdGC")
[System.Text.Encoding]::UTF8.GetString($back)
Для файлов в Windows есть команда certutil -encode исходный.bin результат.txt, но она добавляет к результату строки BEGIN и END, которые не входят в Base64.
Где используется Base64 на практике
- Вложения в электронной почте (стандарт MIME), потому что почтовые протоколы рассчитаны на текст.
- Картинки и шрифты в HTML и CSS через data URI.
- Токены JWT: заголовок и тело закодированы в base64url, и их можно прочитать без ключа.
- Базовая HTTP-авторизация: строка
user:passпревращается вdXNlcjpwYXNzи уходит в заголовке Authorization. - Сертификаты и ключи в формате PEM, где между строками BEGIN и END лежит Base64.
- Передача двоичных данных в API, которые принимают только JSON, как в любом веб-API.
Base64 не шифрует данные. Любой человек раскодирует строку за секунду, ключ не нужен. Нельзя хранить в Base64 пароли и секреты, считая их скрытыми: если в чужом заголовке видите dXNlcjpwYXNz, значит, видите открытые логин и пароль.
Частые ошибки при работе с Base64
- Лишний перевод строки:
echoбез-nдобавляет символ, и результат отличается от ожидаемого. - Кодирование строки вместо байтов: в Python нужен
encode, в JavaScript -TextEncoder. - Потерянный плюс: при передаче в адресе
+превращается в пробел, и декодирование ломается. Используйте base64url или экранируйте символ. - Отсутствие знаков равенства: декодер вроде
b64decodeв Python жалуется на неверное дополнение, поэтому недостающие=нужно вернуть. - Попытка декодировать не Base64: в строке есть символы вне алфавита, например пробелы или переносы из письма.
Если нужно быстро проверить строку, раскодируйте её в Python одной командой base64.b64decode(s) и посмотрите на результат: читаемый текст значит, что данные были текстовыми, а набор непонятных байтов - что внутри файл.