
Что такое строка и как её создать
Строка (тип str) - это последовательность символов Юникода: букв, цифр, пробелов, знаков и эмодзи. Строки можно писать в одинарных или двойных кавычках, разницы нет, пока вы не хотите вставить кавычку внутрь. Для текста на несколько строк подходят тройные кавычки.
a = 'одинарные'
b = "двойные, можно писать 'так'"
c = """первая строка
вторая строка"""
raw = r"C:\new\table"   # r-строка: обратные слеши остаются как есть

print(len(a), a + " и " + b)
print(c)
print(raw)
print("a\tb")           # \t - табуляция, \n - перенос строки
Функция len возвращает количество символов, оператор + склеивает строки, а * повторяет: "ha" * 3 даст hahaha. Префикс r нужен для путей Windows и регулярных выражений: в обычной строке \n превращается в перенос строки, а в r-строке остаётся двумя символами.
Число превращается в строку функцией str(42), а строка в число функциями int("15") и float("2.5"). Склеить строку с числом через плюс нельзя: "Возраст: " + 25 вызовет ошибку TypeError. Используйте str(25) или f-строку, о ней ниже. Перевод строки при выводе делает print сам, а чтобы не переходить на новую строку, пишут print("текст", end="").
Индексы и срезы строк
Каждый символ имеет номер, отсчёт идёт с нуля. Отрицательные индексы считают с конца: -1 это последний символ. Срез s[начало:конец:шаг] берёт символы от начала до конца, не включая конец. Любую часть можно опустить.
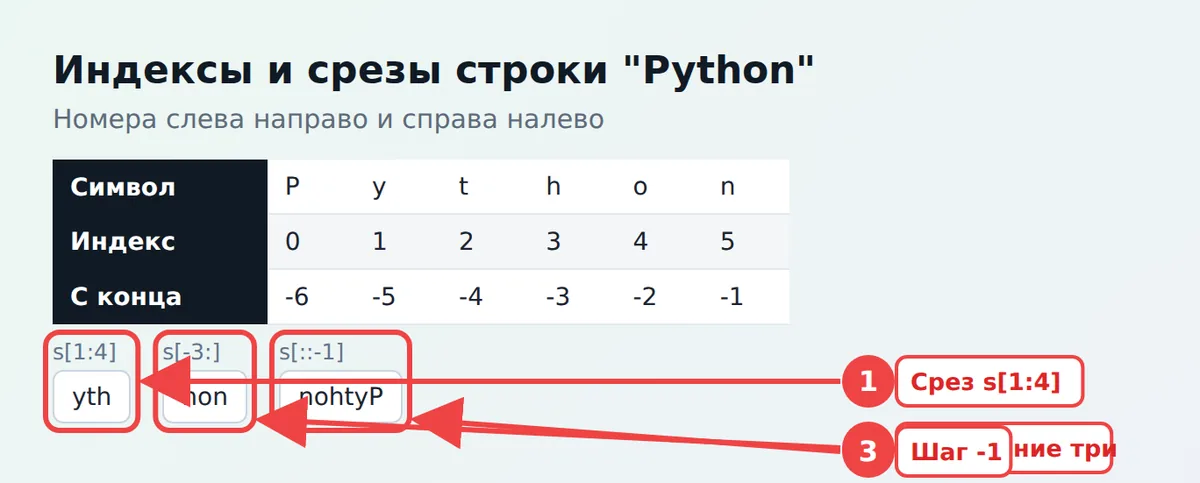
s = "Привет, Python"
print(len(s), s[0], s[-1])   # 14 П n
print(s[:6])                 # Привет
print(s[8:])                 # Python
print(s[::-1])               # nohtyP ,тевирП
print(s[::2])                # Пие,Pto
Первый символ строки это s[0], последний s[-1]. Строка с конца читается срезом с шагом -1. Обращение за пределы строки по индексу (s[100]) вызывает IndexError, а срез за пределами ошибки не даёт и просто вернёт пустую строку или короткий результат. Срезы такого же вида работают и со списками.
Методы строк в Python
Методы вызываются через точку: "текст".upper(). Все они возвращают новую строку или значение, а исходную не меняют. Самые нужные в таблице.
| Метод | Что делает | Пример и результат |
|---|---|---|
| split(sep) | разбивает строку на список | "a,b,c".split(",") даёт ['a', 'b', 'c'] |
| join(список) | собирает строку из списка | "-".join(["2026", "11", "21"]) даёт 2026-11-21 |
| strip() | убирает пробелы и переносы по краям | " ok \n".strip() даёт ok |
| replace(что, чем) | заменяет подстроку | "кот и кот".replace("кот", "пёс", 1) даёт пёс и кот |
| find(подстрока) | индекс первого вхождения или -1 | "hello".find("l") даёт 2 |
| count(подстрока) | сколько раз встречается | "hello".count("l") даёт 2 |
| startswith / endswith | проверяет начало или конец | "report.pdf".endswith(".pdf") даёт True |
| upper / lower | регистр символов | "Hello".upper() даёт HELLO |
| title / capitalize | заглавные буквы | "hello world".title() даёт Hello World |
| format() | подставляет значения в {} | "{} стоит {:.2f}".format("Чай", 99.5) даёт Чай стоит 99.50 |
| isdigit / isalpha | проверяет состав строки | "123".isdigit() даёт True |
| zfill(n) | дополняет нулями слева | "5".zfill(3) даёт 005 |
Разбить строку по разделителю и обратно собрать - самая частая связка. Вызов split() без аргумента делит по любым пробелам и сам выбрасывает пустые элементы, а split(",") оставляет пустые, если запятые идут подряд.
print("a,b,,c".split(","))             # ['a', 'b', '', 'c']
print("a b  c".split())                 # ['a', 'b', 'c']
print("a,b,c".split(",", 1))            # ['a', 'b,c']
print(" ".join("один   два  три".split()))   # один два три
Последняя строка убирает лишние пробелы между словами. Для поиска подстроки есть оператор in: "a" in "cat" даёт True. Метод find нужен, когда важна позиция, а index ведёт себя так же, но при отсутствии подстроки вызывает ошибку ValueError. Если одних методов не хватает, шаблоны ищут регулярными выражениями, проверить их удобно в тестере регулярных выражений.
Список в строку и строка в список
Запрос "список в строку Python" решается методом join, но только если элементы уже строки. Для чисел сначала преобразуйте их через map(str, ...). Обратное действие, строка в список символов, делается функцией list.
nums = [1, 2, 3]
print(", ".join(map(str, nums)))   # 1, 2, 3
print(list("abc"))                 # ['a', 'b', 'c']
Ввод нескольких значений в одну строку делается так: a, b = input().split(), а числа получают дополнительно map(int, input().split()).
F-строки и форматирование
F-строка (с префиксом f) подставляет значения переменных и выражений прямо в фигурные скобки. Это самый читаемый способ собрать текст, и обычно удобнее старого % и метода format(). После двоеточия в скобках задают формат: число знаков, разделитель тысяч, ширину и выравнивание.
name = "Аня"; n = 3; price = 1234.5
print(f"{name}: {n} шт., {price:,.2f}, {n:03d}, {n * 2}")
print(f"{name!r}, {price=}")
print(f"{'влево':<8}|{'центр':^8}|{'вправо':>8}|")
Первая строка выведет Аня: 3 шт., 1,234.50, 003, 6: значение с разделителем тысяч и двумя знаками, число с ведущими нулями и результат выражения. Вторая покажет 'Аня', price=1234.5: флаг !r выводит представление значения с кавычками, а запись {price=} печатает имя и значение, что удобно при отладке. Третья выровняет слова по левому краю, центру и правому краю в полях по 8 символов.
Фигурные скобки в f-строке нужно удваивать, если они должны остаться в тексте: f"{{x}}" выведет {x}. А внутри выражения не пишите те же кавычки, что снаружи, в старых версиях Python это ошибка.
В Python 3.14 появились ещё и t-строки (template strings, префикс t). Они выглядят как f-строки, но возвращают не готовую строку, а объект шаблона с отдельными статичными и подставляемыми частями. Они нужны библиотекам, которые должны безопасно собирать SQL или HTML, и начинающему для обычных задач не требуются: для вывода и сборки текста остаются f-строки.
Неизменяемость строк
Строки в Python неизменяемы: после создания символ внутри заменить нельзя. Попытка присвоить значение по индексу даёт ошибку, а все методы вроде replace или upper возвращают новую строку, оставляя исходную как была. Если не присвоить результат переменной, он потеряется.
s = "Привет"
try:
    s[0] = "п"
except TypeError as e:
    print("TypeError", e)

s = "п" + s[1:]      # собираем новую строку
print(s)             # привет
s.upper()            # результат нигде не сохранён
print(s)             # привет (не изменилась)
Ошибка прочитается как "'str' object does not support item assignment". Чтобы заменить один символ, соберите новую строку срезами или методом replace. Когда нужно многократно менять текст, соберите части в список и в конце объедините через "".join(parts): склейка плюсом в цикле на больших объёмах работает медленно. Неизменяемость нужна и для того, чтобы строки могли быть ключами словаря, подробнее об этом в статье про хешируемые и неизменяемые объекты.
Кодировки: коротко
Внутри программы строка Python хранит символы Юникода. Когда вы записываете её в файл или отправляете по сети, она превращается в байты методом encode, а обратно возвращается через decode. Стандартная кодировка для этого - UTF-8, в ней русская буква занимает два байта.
print("é".encode("utf-8"))                  # b'\xc3\xa9'
data = "Привет".encode("utf-8")
print(len("Привет"), len(data))            # 6 12
print(data.decode("utf-8"))                # Привет
print(len("Привет".encode("cp1251")))      # 6
Шесть символов дают двенадцать байт в UTF-8 и шесть байт в cp1251 (старая кодировка Windows). Если прочитать байты не той кодировкой, получатся кракозябры или ошибка UnicodeDecodeError. При работе с файлами указывайте кодировку явно: open("a.txt", encoding="utf-8"). О причинах кракозябр и способах их исправить подробно рассказано в статье про кодировку UTF-8, а перевод байтов в текстовый вид для передачи разобран в статье о Base64.
Частые вопросы новичков: комментарии, задачи и ошибки
Закомментировать строку в Python можно символом #, всё после него до конца строки игнорируется. Отдельного многострочного комментария в языке нет: на несколько строк ставят # в начало каждой (в большинстве редакторов это сочетание Ctrl+/ на выделенных строках). Тройные кавычки создают строку-документацию, а не комментарий, поэтому для кода их использовать не стоит.
TypeErrorпри сложении строки и числа: приведите число к строке или используйте f-строку.- Метод ничего не изменил: строки неизменяемы, присвойте результат
s = s.strip(). - Лишние пробелы и перенос в конце ввода: вызывайте
.strip()послеinput()и чтения файлов. - Сравнение без учёта регистра: приводите обе строки к
lower()или используйтеcasefold(). - Обратные слеши в путях Windows: пишите r-строки или заменяйте слеши на прямые.
Чтобы закрепить, решайте небольшие задачи: подсчёт гласных, проверка палиндрома, разворот слов. Готовые условия с разбором есть в подборке задач на Python для начинающих. Когда логика повторяется, оформляйте её в функцию.